Нейросети могут уверенно отвечать на вопросы даже тогда, когда данных у них недостаточно. Из-за этого правдоподобный ответ не всегда оказывается правильным.
У разных моделей ошибки проявляются по-разному: одни чаще путают факты, другие лучше признают неопределённость или аккуратнее работают с источниками.
Сравним несколько популярных нейросетей и посмотрим, какие из них точнее отвечают на вопросы и реже выдумывают детали.
Какие нейросети сравним на одинаковых вопросах
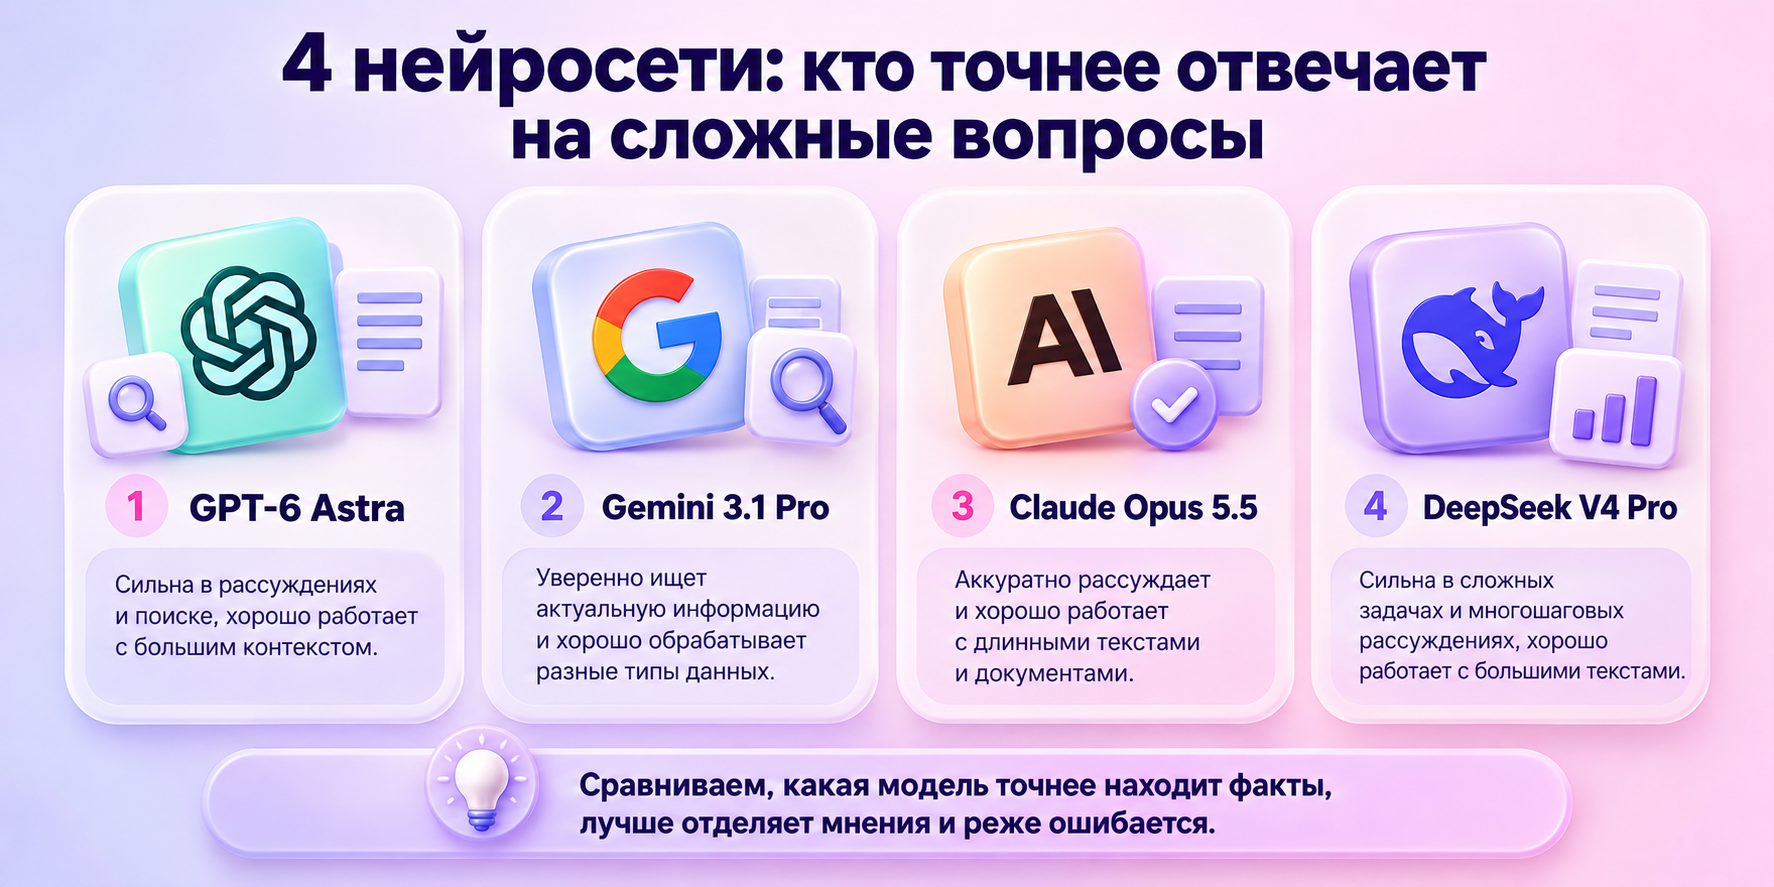
GPT-6 Astra
GPT-6 Astra — флагманская модель OpenAI для сложных задач, где важны рассуждение, поиск и работа с большим объёмом контекста. Она поддерживает веб-поиск и длинное контекстное окно, поэтому подходит для вопросов, где нужно сопоставлять несколько источников и проверять факты. При этом даже сильная модель может ошибаться, поэтому в сравнении отдельно посмотрим, насколько уверенно она отвечает там, где данных недостаточно.
Gemini 3.1 Pro
Gemini 3.1 Pro — старшая модель Google для сложных запросов, длинного контекста и работы с разными типами данных. Она поддерживает поиск как инструмент, поэтому подходит для вопросов, где важна проверка актуальной информации по внешним источникам. В нашем сравнении отдельно посмотрим, насколько хорошо модель отделяет подтверждённые факты от предположений и признаёт неопределённость.
Claude Opus 5.5
Claude Opus 5.5 — старшая модель Anthropic для сложных задач, анализа документов и запросов, где требуется аккуратное рассуждение. В SpeShu.AI она доступна среди основных текстовых моделей. Для нашего сравнения она интересна тем, как работает с неоднозначными вопросами и насколько осторожно формулирует ответ, если уверенности в фактах недостаточно.
DeepSeek V4 Pro
DeepSeek V4 Pro — старшая модель линейки DeepSeek V4, рассчитанная на сложные рассуждения, работу с большими текстами и многошаговые задачи. В SpeShu.AI доступны V4 Pro и V4 Flash, но для сравнения точности логичнее взять именно Pro как более мощный вариант.
Чем увереннее звучит ответ нейросети, тем важнее проверить факты: убедительный тон сам по себе не означает, что модель права.
Редакция SpeShu.AI
Как проверить ответ нейросети перед использованием
- Сверьте ключевые факты с первичным источником: официальной документацией, сайтом компании, исследованием или другим надёжным материалом.
- Проверьте даты, имена, цифры и названия документов отдельно — именно в таких деталях модель может ошибиться, даже если остальная часть ответа выглядит убедительно.
- Проверьте ссылки и источники, которые указала модель: они должны существовать и действительно подтверждать тезис.
- Если ответ касается свежих событий, убедитесь, что информация актуальна на текущую дату.
- Отделяйте факты от предположений: формулировки вроде «вероятно» или «можно предположить» не равны подтверждённым данным.
- Для важных решений перепроверьте ответ хотя бы по двум независимым источникам, а не опирайтесь только на одну нейросеть.
Для сравнения мы задали четырём моделям пять одинаковых вопросов: на простой факт, ложную предпосылку, нехватку данных, работу с источниками и актуальную информацию. Например, спрашивали, почему столицей Австралии стала Канберра, кто получил Нобелевскую премию по математике в 2025 году и можно ли определить место работы человека по нескольким общим сведениям.
За точный ответ без выдумок модель получала 2 балла, за небольшую неточность — 1, за ошибку или придуманную информацию — 0.
GPT-6 Astra — 9/10. Хорошо работала с источниками, заметила ложную предпосылку и не стала додумывать недостающие данные.
Claude Opus 5.5 — 9/10. Лучше других признавала нехватку информации и осторожно формулировала ответы.
Gemini 3.1 Pro — 8/10. Справилась со свежими данными, но в одном ответе добавила деталь, которую пришлось перепроверять.
DeepSeek V4 Pro — 7/10. Уверенно отвечала на простые вопросы, но чаще пыталась заполнить пробелы неподтверждёнными деталями.
В нашем демонстрационном тесте наиболее ровно выступили GPT-6 Astra и Claude Opus 5.5. Но важен не только итоговый балл: для фактических вопросов полезнее модель, которая умеет признать неопределённость, показать источники и не выдаёт догадку за факт.
Точность важнее уверенного тона
Если ответ влияет на решение, попросите нейросеть показать источники и перепроверьте ключевые факты отдельно. В SpeShu.AI можно задать один и тот же вопрос нескольким моделям и сравнить, где их ответы расходятся.